Закончилось место на диске Linux: df, inode и удалённые файлы
Разбираем No space left on device: блоки, inode, отдельные разделы и открытые удалённые файлы. С реальными опытами и готовым скриптом диагностики без очистки.
Сообщение No space left on device не всегда означает, что нужно купить диск побольше. Могли закончиться блоки данных, inode для новых файлов или место в отдельном разделе. Ещё один случай: файл удалён из каталога, но процесс продолжает держать его открытым, и блоки пока не освобождаются.
Ниже — порядок диагностики Ubuntu и готовый скрипт, который только читает показатели. Проверено 29 октября 2026 года на Ubuntu 24.04.5. Переполнение воспроизводилось в двух отдельных tmpfs по 8 МиБ. Корневую файловую систему сервера мы не заполняли; снимки показывают управляемый учебный опыт.
Определить файловую систему проблемного пути
Если ошибка появилась при записи в /var/lib/myapp, проверяйте именно этот путь или его существующий родительский каталог:
df -hT /var
df -i /var
findmnt -T /var
df -hT показывает доступные блоки и тип файловой системы, df -i — количество свободных inode, findmnt — где расположен указанный путь. Проверка только / может пропустить заполненный отдельный /var, Docker volume или tmpfs.
| Наблюдение | Что исследовать дальше |
|---|---|
| Мало доступных байтов, inode есть | Большие файлы, журналы, архивы, открытые удалённые файлы |
| Байты свободны, inode почти нет | Большое число маленьких файлов, кэш, сессии, очереди |
| В обоих отчётах место есть | Другой mount, квота, ограничение контейнера, права, режим read-only |
На некоторых файловых системах есть резерв блоков и собственные особенности учёта. Поэтому проценты df и сумма файлов из du не обязаны совпадать до байта. Если в сообщении указана квота (Disk quota exceeded), исследуйте квоту пользователя или проекта отдельно.
Найти крупные каталоги без перехода на другие диски
sudo du -x -h --max-depth=1 /var | sort -h
sudo du -x -h --max-depth=1 /var/lib | sort -h
Идите от крупного каталога к его подкаталогам. Параметр -x удерживает обход в пределах одной файловой системы: вложенный другой раздел нужно исследовать отдельно. На большом дереве du создаёт нагрузку на диск, поэтому не запускайте одновременно несколько полных обходов сервера.
Типичные кандидаты — журналы приложения, локальные копии базы, архивы релизов, пользовательские загрузки и кэши. Сначала определите владельца и назначение. Файлы в /var/lib/postgresql, /var/lib/mysql и Docker volumes нельзя считать мусором по одному размеру.
Почему df занят, а du почти ничего не видит
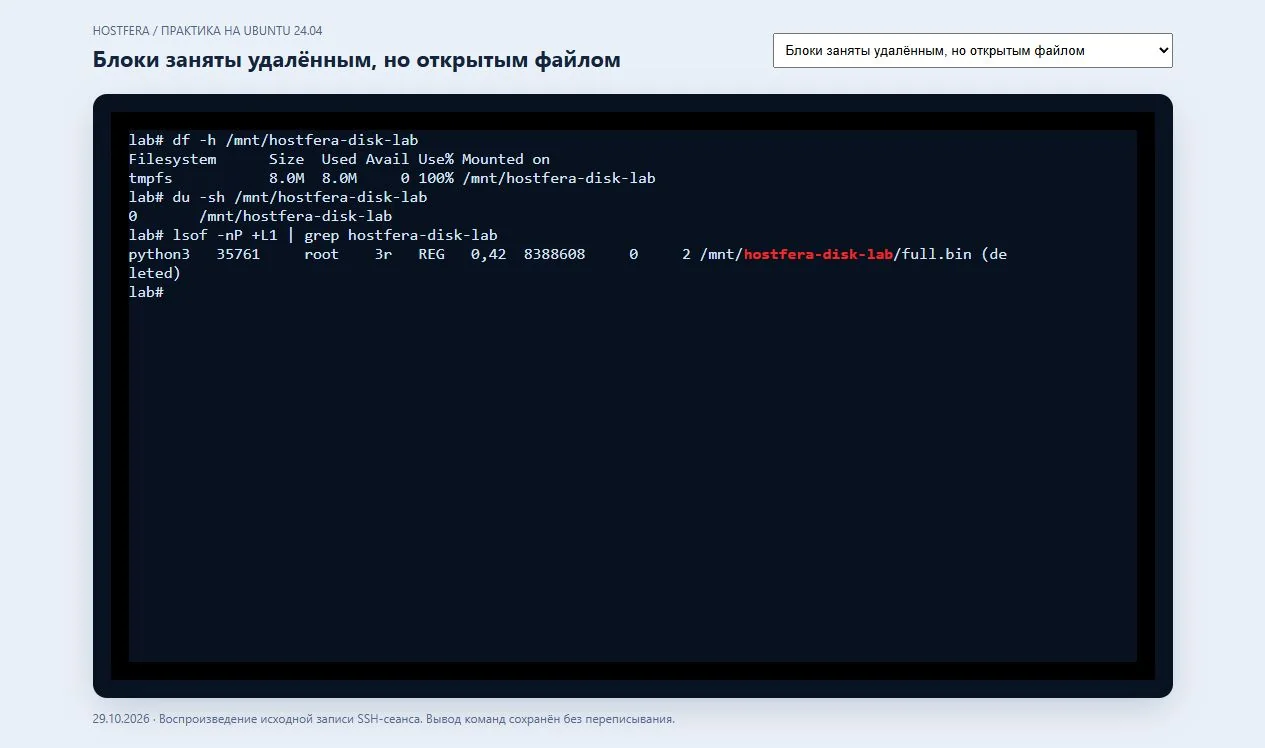
На стенде файловая система /mnt/hostfera-disk-lab заполнена на 100%, но du видит 0. Мы создали файл 8 МиБ, открыли его отдельным процессом и удалили имя файла из каталога. Процесс продолжал держать дескриптор, поэтому блоки остались заняты.
Проверка:
sudo lsof +L1
Сопоставьте имя файла, устройство, процесс и столбец SIZE/OFF. Большой удалённый лог может объяснить расход. Само слово (deleted) не доказывает проблему: нулевые временные файлы и некоторые служебные объекты могут быть нормальными.
Освободить блоки можно, когда владелец закроет файл. Для реального сервиса выясните, как он переоткрывает журналы после ротации; при необходимости запланируйте штатный перезапуск именно этого сервиса с учётом влияния на пользователей. Не завершайте неизвестные PID и не обнуляйте /proc/.../fd/... по чужому примеру. На нашем изолированном опыте завершение собственного процесса освободило место; это не рекомендация перезапускать весь сервер.
Почему файл не создаётся при свободных гигабайтах
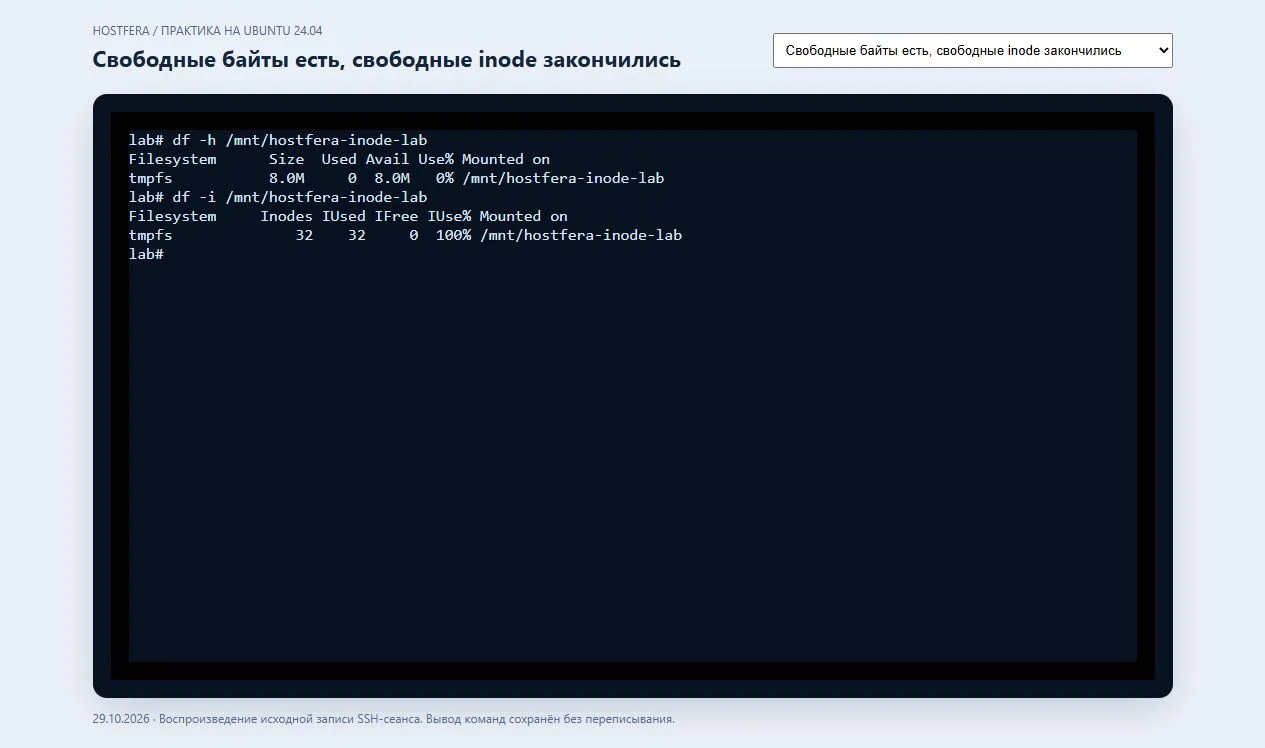
Второй опыт: tmpfs ограничен 32 inode. После создания 31 пустого файла вместе с корневым каталогом заняты все 32. df -h показывает свободные 8 МиБ, а df -i — 100% использования inode. Новое имя файла создать уже нельзя.
Для поиска большого числа объектов можно использовать GNU du:
sudo du --inodes -x --max-depth=1 /var | sort -n
Затем сузьте путь. Частые причины — старые сессии, файловый кэш и неограниченная очередь мелких заданий. Политику удаления задавайте по правилам приложения: возраст, статус, допустимость повторного создания. Если просто увеличить объём диска, проблема inode может сохраниться; результат зависит от файловой системы и способа расширения.
Скачать скрипт сбора диагностики
Скачать hostfera-disk-report-1.0.0.sh. Скрипт не удаляет файлы, не меняет настройки и не перезапускает службы. Он показывает блоки, inode, размер каталогов первого уровня, первые 30 строк lsof +L1 по всему серверу и объём systemd journal. На большом каталоге обход может занять время.
curl --fail --show-error --location \
  https://hostfera.ru/static/downloads/hostfera-disk-report-1.0.0.sh \
  --output hostfera-disk-report-1.0.0.sh
sha256sum hostfera-disk-report-1.0.0.sh
less hostfera-disk-report-1.0.0.sh
sudo bash hostfera-disk-report-1.0.0.sh /var
SHA-256 версии 1.0.0:
543bf98c45622acceca8ade80b2f520c28263d66436932f6769fd29d0763ac18
Сохранить отчёт можно перенаправлением в файл на другой файловой системе с доступным местом. Отчёт содержит пути и названия процессов: перед отправкой третьим лицам удалите приватные сведения. Успешное завершение скрипта означает, что сбор дошёл до конца; читайте также сообщения Permission denied и другие ошибки отдельных команд.
Полный код скрипта
#!/usr/bin/env bash
# Hostfera: collect filesystem diagnostics without changing files.
set -uo pipefail
[[ $# -le 1 ]] || { echo 'Использование: sudo bash hostfera-disk-report-1.0.0.sh /путь' >&2; exit 1; }
TARGET=$(realpath -e -- "${1:-/var}") || exit 1
[[ -d $TARGET ]] || { echo 'Укажите существующий каталог.' >&2; exit 1; }
printf 'HOSTFERA / ДИАГНОСТИКА ДИСКА\nUTC: %s\nКаталог: %s\n' "$(date -u +%FT%TZ)" "$TARGET"
printf '\n== Файловая система и свободные блоки ==\n'
df -hT -- "$TARGET"
printf '\n== Свободные inode ==\n'
df -i -- "$TARGET"
printf '\n== Каталоги первого уровня в этой файловой системе ==\n'
du -x -h --max-depth=1 -- "$TARGET" 2>&1 | sort -h
printf '\n== Удалённые файлы, которые ещё открыты процессами ==\n'
if command -v lsof >/dev/null; then
  lsof +L1 2>/dev/null | head -n 30 || true
else
  printf 'lsof не установлен. При необходимости установите пакет lsof.\n'
fi
printf '\n== Объём журнала systemd ==\n'
if command -v journalctl >/dev/null; then journalctl --disk-usage; fi
printf '\nОтчёт собран. Сопоставьте устройство, блоки, inode и открытые файлы.\n'
Запускайте через sudo, чтобы видеть системные каталоги и процессы. На минимальной Ubuntu lsof может отсутствовать: при необходимости установите его штатным sudo apt install lsof, когда есть место для установки. Отсутствующий пакет скрипт отмечает в отчёте. Другой путь передаётся первым аргументом; несуществующий каталог отвергается.
Освободить место по найденной причине
Для systemd сначала посмотрите journalctl --disk-usage, затем выберите допустимую глубину хранения с учётом расследования ошибок. Для приложения настройте ротацию и переоткрытие логов. Для локальных резервных копий проверьте независимую копию и тест восстановления, затем примените согласованную политику хранения.
В Docker начните с docker system df и проверки назначения образов, контейнеров и томов. Не запускайте массовую очистку с удалением volumes: там могут храниться базы и пользовательские файлы. Не удаляйте вручную WAL PostgreSQL, журналы транзакций других СУБД или содержимое /tmp работающего приложения.
Если место съедают нужные данные, перенос или расширение диска может оказаться правильным решением. Различие между планированием объёма и текущей аварией разобрано в статье о диске для сайта.
Проверить восстановление работы и предотвратить повторение
Повторите df -hT и df -i для того же пути, проверьте журнал пострадавшего сервиса и штатную запись через приложение. Существующая страница может открываться из кэша, когда база всё ещё не может записать данные. Проверку чтения дополните контролируемой записью тестового объекта.
Настройте наблюдение за доступными байтами и inode на каждой нужной файловой системе, ростом журналов и возрастом резервных копий. Для PostgreSQL используйте копирование с отдельным восстановлением. Для ошибок веб-сервера сопоставляйте симптом с журналами сайта и конкретным кодом ответа, а не удаляйте файлы наугад.
Первоисточники
Сообщите адрес статьи и фрагмент через контакты редакции.
Продолжайте разбираться
Все по теме ↗ VPS
Как выбрать VPS для первого проекта
Разбираем CPU, память, диск, регион и доступ из интернета. Помогаем выбрать первый VPS под сайт или приложение и п…
ХостингКак исправить ошибку 413 в Nginx при загрузке файла
Находим источник 413, меняем client_max_body_size в нужном маршруте и проверяем маленький и слишком большой запрос…
VPSРезервная копия PostgreSQL: скрипт pg_dump и проверка восстановления
Готовый скрипт дампа PostgreSQL, контрольная сумма и восстановление в отдельную базу. Проверенный опыт: три записи…