Как проверить robots.txt и sitemap.xml перед индексацией
Проверяем правила обхода, noindex, canonical и XML-карту. Разбираем, что убрать после разработки и какие страницы оставить закрытыми.
После открытия сайта поисковик должен получить доступ к нужным страницам и понять, какие адреса вы считаете основными. Для этого проверяют не один файл, а согласованность robots.txt, sitemap.xml, ответов сервера и настроек самих страниц.
В этом руководстве разберём проверку небольшого сайта после разработки или переноса. Для примеров используем example.com: в командах замените его своим доменом. Если сайт пока закрыт для посетителей, сначала завершите проверку доступа; порядок есть в статье как проверить сайт после запуска.
Что делает каждый механизм
Robots.txt задаёт правила обхода для поисковых роботов. Sitemap перечисляет адреса, которые вы хотите помочь им обнаружить. Canonical указывает предпочтительный адрес страницы. Директива noindex сообщает, что полученную страницу не нужно включать в результаты поиска.
Эти механизмы не заменяют друг друга. Наличие URL в карте не отменяет запрет на странице. Удаление строки Disallow не исправляет ошибочный редирект. А доступная карта не гарантирует, что поисковик проиндексирует все материалы: сначала нужно проверить, что страницы содержательны, открываются и связаны обычными ссылками.
Шаг 1. Откройте robots.txt правильного сайта
Проверьте https://example.com/robots.txt. Файл должен находиться в корне нужного хоста. Правила другого поддомена нельзя автоматически считать правилами основного сайта. Если основной адрес работает по HTTPS, проверяйте именно его.
В PowerShell:
curl.exe -i https://example.com/robots.txt
В Linux и macOS используйте curl вместо curl.exe. Посмотрите и код ответа, и тело. Вместо файла может открыться HTML-заглушка, страница входа или сообщение CDN. В таком случае сначала исправьте отдачу файла, а затем разбирайте его правила.
Шаг 2. Прочитайте правила для нужного робота
Простой пример для открытого информационного сайта:
User-agent: *
Allow: /
Disallow: /admin/
Disallow: /search/
Sitemap: https://example.com/sitemap.xml
Здесь общий раздел сайта открыт для обхода, а служебные пути ограничены. Это пример структуры, а не готовый файл для любого проекта: у вашей панели может быть другой путь, а часть поиска может требовать иного решения.
Проверьте, нет ли отдельной группы для Googlebot или Yandex. Она может задавать правила, отличающиеся от общей группы. Если важный материал не обходится, проверяйте его полный путь и правила подходящей группы, а не только наличие Allow: / где-нибудь в файле.
Для подготовки простого варианта можно воспользоваться генератором robots.txt. После размещения обязательно проверьте фактический файл на домене: скачанный пример и рабочая конфигурация могут различаться.
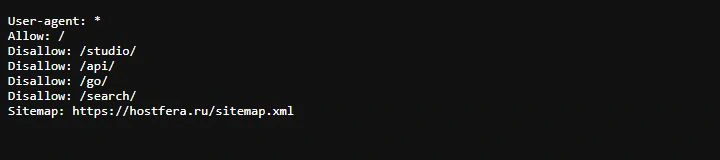
На снимке — рабочий robots.txt Hostfera после открытия 28 октября 2026 года. Для статей обход разрешён, служебные пути исключены, указан адрес карты сайта.
Шаг 3. Убедитесь, что не остался запрет разработки
Типичная причина проблем после запуска — сохранённый общий запрет:
User-agent: *
Disallow: /
Но удаление этой строки ещё не означает, что сайт готов к индексации. Откройте важную статью без авторизации. Она должна возвращать содержимое, а не заглушку или страницу входа.
Также проверьте HTML и HTTP-заголовки страницы. Случайный <meta name="robots" content="noindex"> или X-Robots-Tag: noindex может остаться после отключения режима разработки. Проверяйте именно публичную страницу: предпросмотр редактора иногда намеренно закрыт от поиска.
Шаг 4. Не используйте robots.txt как защиту данных
Путь, запрещённый для обхода, остаётся технически доступным по прямой ссылке, если сервер не требует авторизации. Поэтому закрытые журналы, копии базы и панель управления защищают средствами сервера и приложения.
Не стоит также считать Disallow универсальным способом удалить URL из поиска. Если робот не может получить страницу, он может не увидеть установленный на ней noindex. Для удаления уже известной страницы выберите подходящий способ и проверьте рекомендации конкретного поисковика. Временное закрытие проекта, удаление страницы и запрет обхода — разные задачи.
Шаг 5. Проверьте sitemap.xml
Откройте адрес из строки Sitemap в robots.txt. В карте должны быть основные публичные адреса. Для небольшого сайта это может быть один XML-файл; для крупного — индекс, который ссылается на несколько карт.
curl.exe -I https://example.com/sitemap.xml
curl.exe -sS https://example.com/sitemap.xml
Посмотрите, что внутри действительно XML с URL, а не HTML-страница ошибки. Проверьте несколько записей: правильный ли протокол, основной ли домен, нет ли адреса тестового стенда. Особое внимание уделите материалам, которые только что опубликовали или перенесли.
Карта должна формироваться из тех страниц, которые доступны и предназначены для поиска. Черновики, приватные отчёты, редиректы и несуществующие материалы не стоит включать ради увеличения количества URL.
Шаг 6. Сопоставьте URL карты со страницей
Возьмите адрес статьи из карты и откройте его без входа. Проверьте четыре вещи: ответ 200, нужный текст, отсутствие случайного noindex и согласованный canonical. Если canonical ведёт на другой адрес, выясните, почему в карте указан этот URL.
Проверьте изображения статьи. Бывает, что текст открыт, а иллюстрации доступны только редактору. Для читателя и поискового робота такой материал неполон. После переноса дополнительно посмотрите, не ведут ли медиа на прежний домен.
Если у записи есть lastmod, дата должна отражать содержательное обновление, а не меняться при каждом открытии карты. Небольшая правка служебной настройки не является поводом объявлять весь архив заново обновлённым.
Шаг 7. Проверьте разделы и внутренние ссылки
Новая статья должна быть доступна из раздела, маршрута обучения или связанного материала. Если она существует только в XML, посетителю всё ещё трудно её найти. Добавляйте ссылки там, где они отвечают на следующий вопрос читателя.
Например, после создания VPS полезны подключение по SSH, настройка Nginx и HTTPS. После выбора конфигурации — расчёт полной стоимости сервера. Десятки одинаковых ссылок внизу каждой страницы не заменяют такую последовательность.
Шаг 8. Передайте карту поисковикам и наблюдайте
После открытия добавьте или проверьте сайт в Google Search Console и Яндекс Вебмастере, подтвердите доступ и отправьте адрес карты. Для конкретного материала используйте доступные в кабинете средства проверки URL. Сам факт отправки карты ещё не означает появление страницы в поиске.
При ошибке изучайте указанный адрес и причину: недоступность сервера, запрет, редирект, другой canonical или недостаточная ценность страницы требуют разных действий. Не отправляйте одну и ту же карту снова вместо исправления причины.
Для первичного осмотра сайта подойдёт анализ Hostfera: он проверяет доступные технические признаки, включая правила индексации. Точные сведения о том, какие страницы включены в поиск и по каким запросам они показываются, смотрите в кабинете своего сайта.
Короткая проверка перед завершением
Откройте главную и статью в приватном окне, затем robots.txt и sitemap.xml. Сверьте один URL из карты с canonical этой статьи и убедитесь, что noindex не остался случайно. Проверьте переход к статье из раздела и загрузку её изображений. После этого переходите к наблюдению за обработкой сайта поисковиками, а не к бесконечному изменению правил без причины.
Первоисточники
Сообщите адрес статьи и фрагмент через контакты редакции.
Продолжайте разбираться
Все по теме ↗ Хостинг
Как проверить сайт после запуска: DNS, HTTPS и ошибки
Пошаговая проверка сайта без входа администратора: домен, перенаправления, сертификат, файлы, формы, 404 и доступ …
 Хостинг
Как проверить сайт перед переключением DNS
Проверка нового хостинга через hosts и curl --resolve: HTTPS, формы, медиа, база, интеграции и контрольный список …
 Хостинг
Как привязать домен к хостингу
Пошаговое подключение домена: действующая DNS-зона, A и AAAA, www, сохранение почты, проверка записей и установка …